语音转文字技术实践,分片、保活、声纹:内网转写系统的四个关键实现
经过半个月的时间不断学习和模型的训练,调试,整个语音识别这块的技术栈进行研究,本次主要是端到端,不调用互联网的API接口,自己通过小模型的学习,实现一套支持语音文件识别文字、识别声纹、杂波过滤、支持在线校对等于一体的语音识别文字,整个效果可以实现技术自主可控,成本低廉和可以正式使用的工具;
下面直接先看效果:
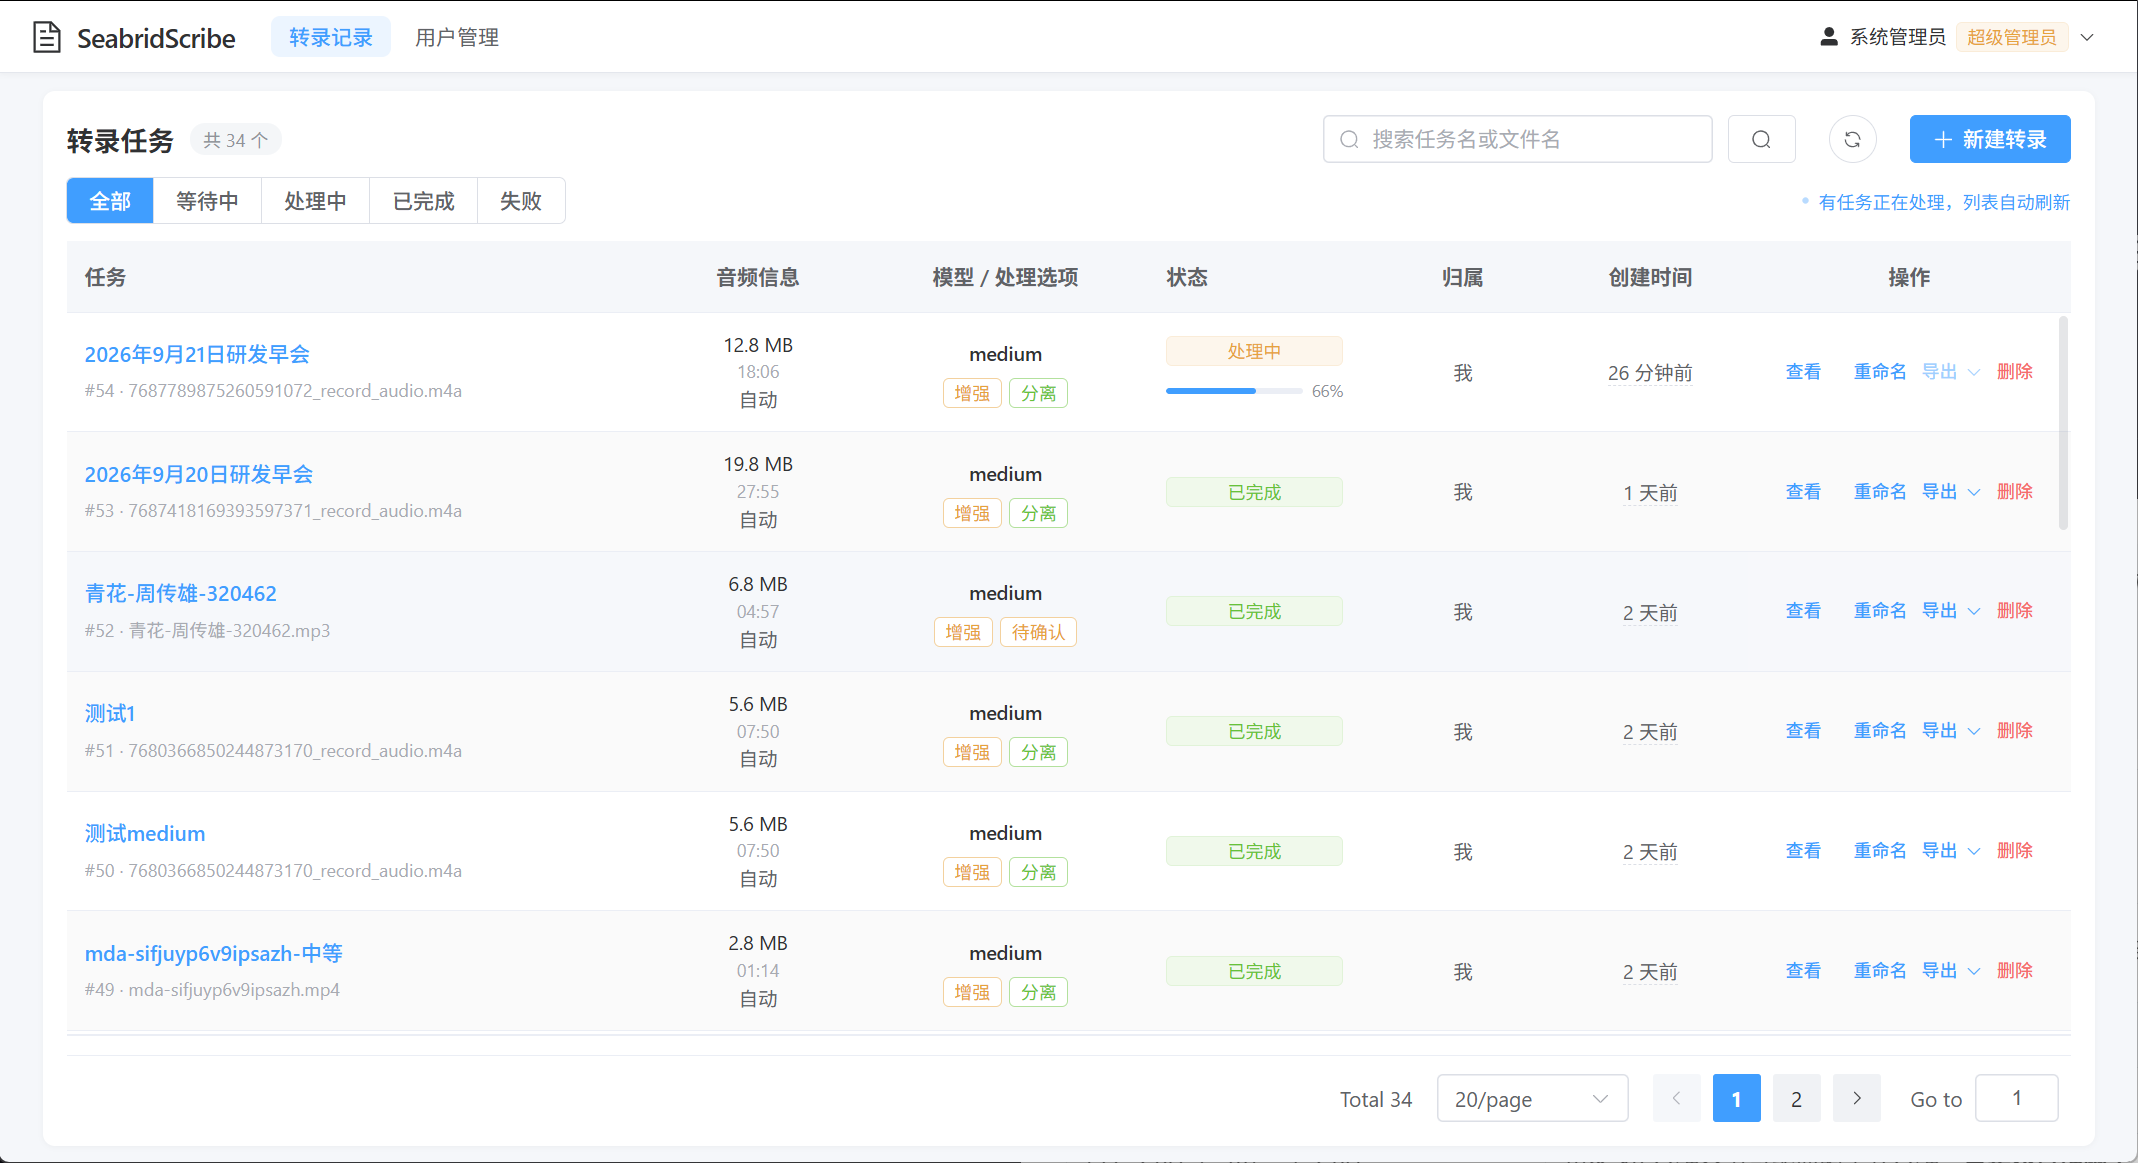
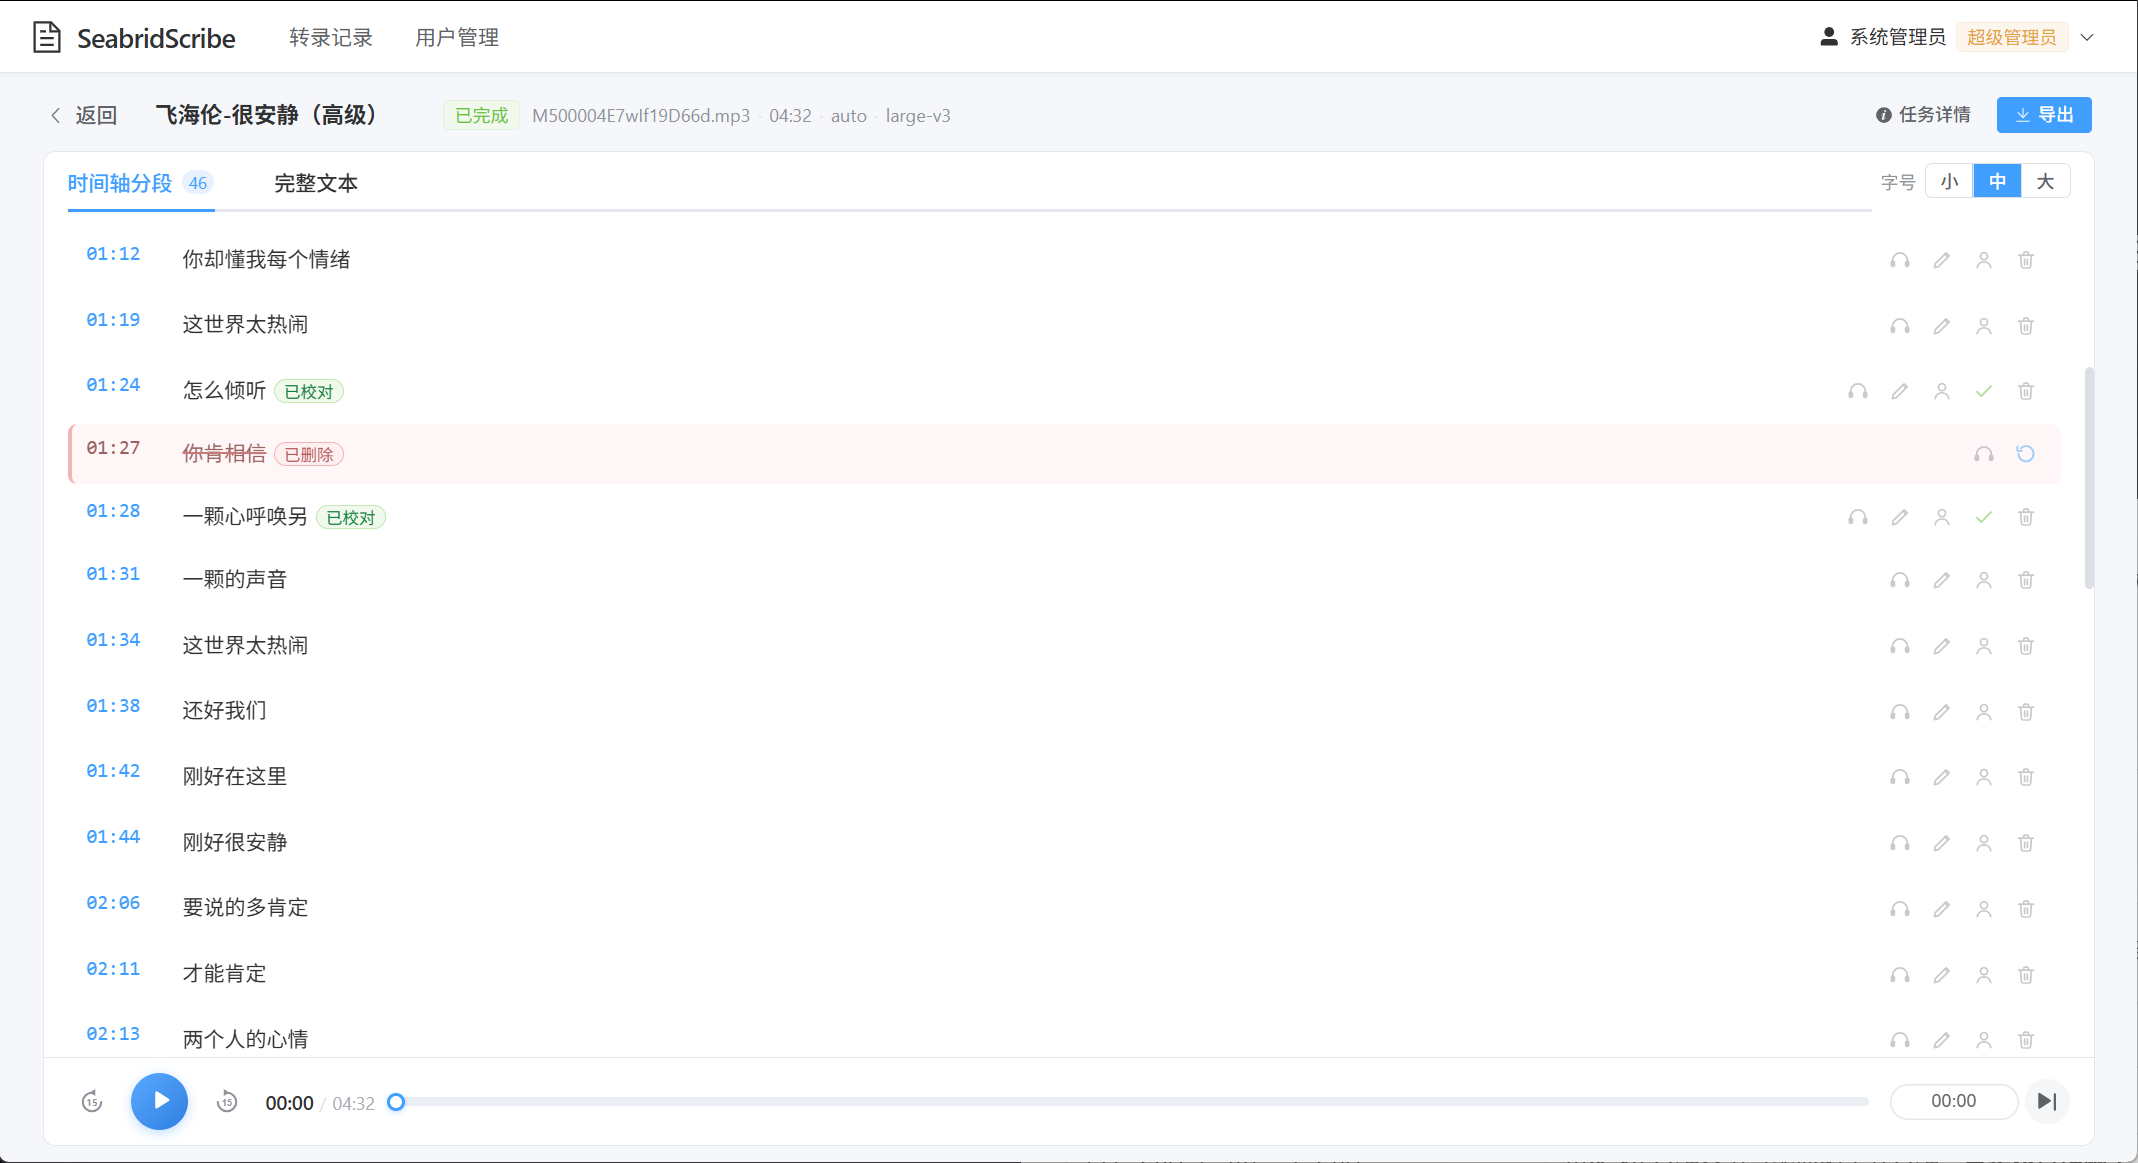
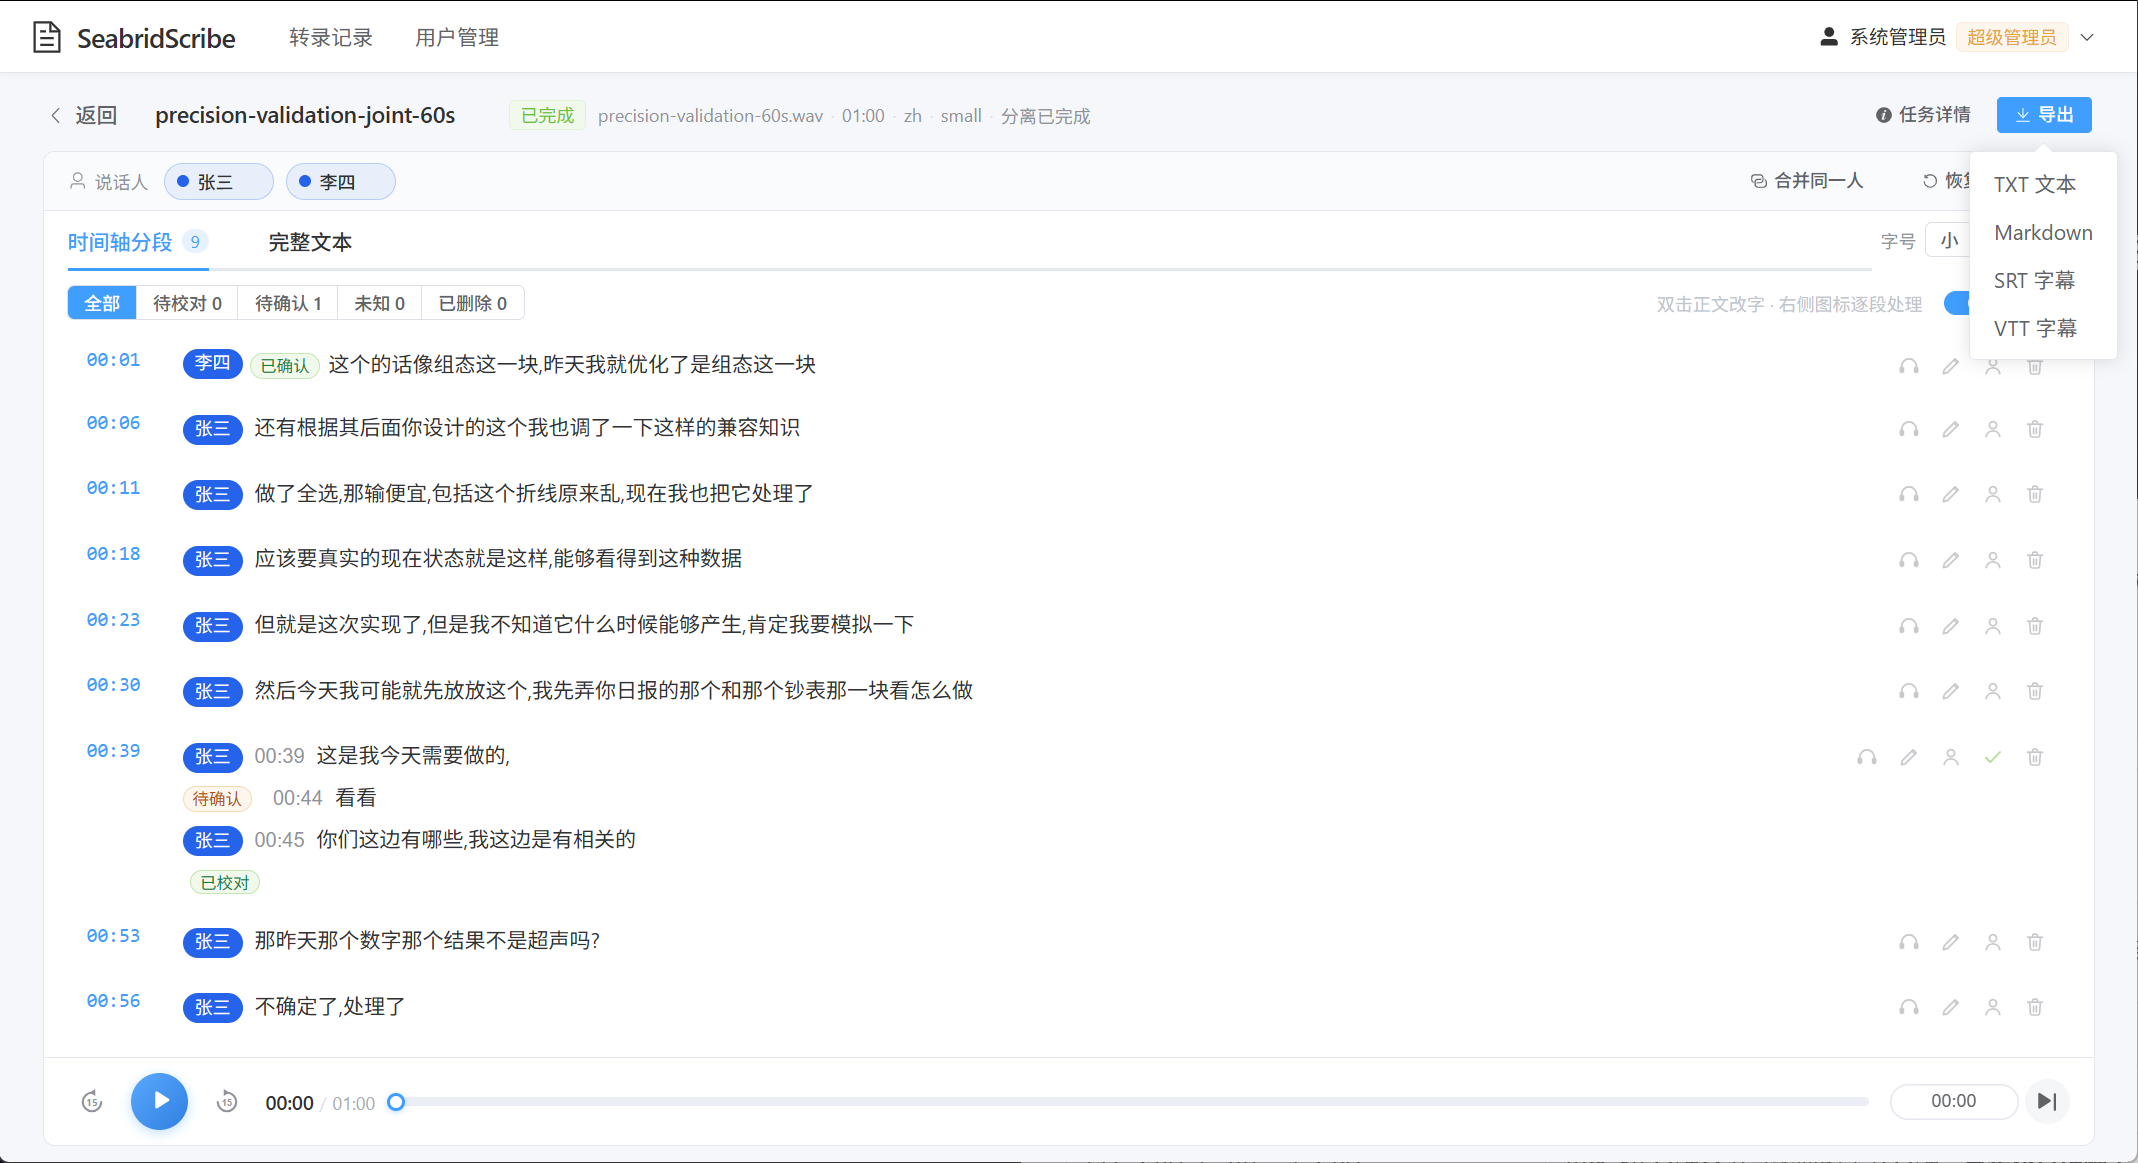
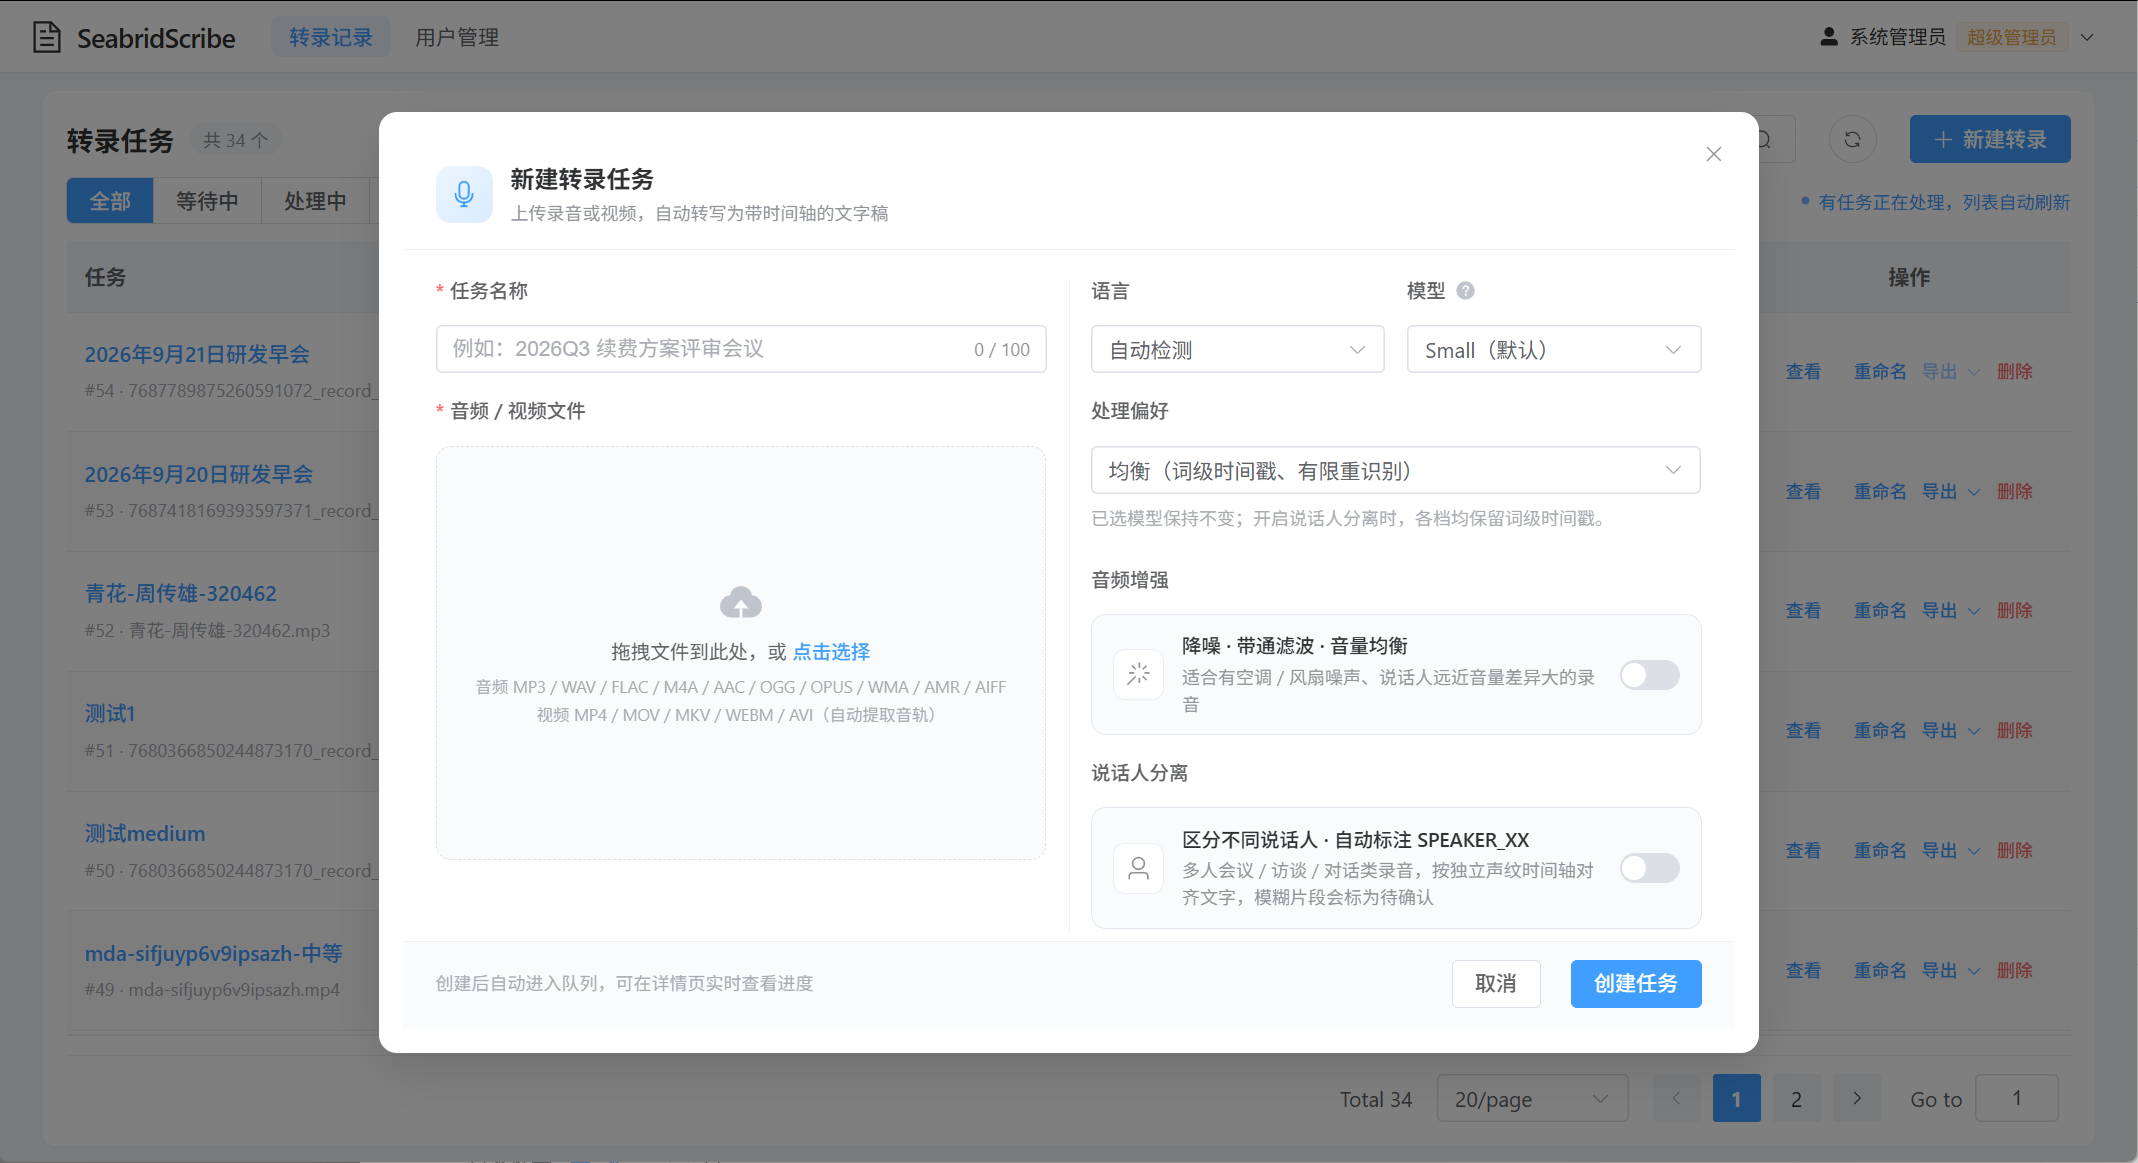
只有 CPU、没有 GPU 的本地化音视频转写系统:上传音视频 → 异步转写 → 带时间戳的分段文字 → 在线播放与时间轴跳转 → 人工校对 → 四格式导出。
本文讲的是怎么做到的,以及哪些地方真机上才会疼。全文不含任何内部标识、凭据与目录信息。
1. 先说清楚约束:这套系统的难点不在"能转写"
调一个 whisper 把音频变成文字,是个下午的工作量。真正的难点来自下面这些约束,它们决定了架构长什么样:
| 约束 | 直接后果 |
|---|---|
| 数据不出内网 | 不能用云端 ASR API,模型必须本地跑、可离线加载 |
| 只有 CPU(int8),无 GPU | 单条 19 分钟会议可能要跑十几分钟,异步化是硬需求,不是优化项 |
| 用户要看到"在动" | 长任务必须有实时进度,否则用户会反复刷新、重复提交 |
| 会议录音动辄 1 小时+ | 必须分片,且分片不能丢上下文、不能重复、进度不能算错 |
| 音频是"任意来源" | 手机录音、微信语音、歌曲、视频抽音轨,格式与信噪比全都不可控 |
| 要区分多人 | 说话人分离必须做,但不能编造说话人 |
| 结果要被人改 | 人工校对后的结果不能被重跑覆盖,误删必须可逆 |
一句话总结:这是一个人机协作系统,不是一个转写 API。
2. 技术选型总览
| 层 | 选型 | 选它的理由 |
|---|---|---|
| Web 框架 | FastAPI + Uvicorn | 原生 async、Pydantic 校验、自带 OpenAPI 文档 |
| ORM | SQLAlchemy 2.x(asyncio) | API 侧全异步;同一套模型给同步 worker 复用 |
| 数据库 | MySQL 8.4 LTS | 共享实例、运维熟悉、utf8mb4 稳定 |
| 异步驱动 | asyncmy(API) / pymysql(worker、迁移) |
Celery 与 Alembic 不支持 asyncio,两条驱动同库并存 |
| 任务队列 | Celery 5.4 + Redis 7 | 长任务、可取消、可重派;Redis 同时承担进度 Pub/Sub |
| 迁移 | Alembic | 结构变更有版本、可回退;另出幂等离线 SQL 兜底 |
| 配置 | Pydantic v2 + pydantic-settings | 环境变量优先,配置即类型 |
| 语音识别 | faster-whisper(CTranslate2)+ FFmpeg | CPU int8 可用,无需 GPU;多档模型可切 |
| 声纹 | SpeechBrain ECAPA-TDNN | 公开仓库、免令牌,见 §7.2 |
| 前端 | Vue 3 + TypeScript + Vite + Pinia + Element Plus | 组合式 API + 强类型 + 轻量状态管理 |
| HTTP | Axios(响应拦截器统一解包) | 后端统一信封 {code, message, data},前端只处理 data |
| 部署 | Docker Compose | 数据库/缓存可选 profile,默认连外部共享实例 |
2.1 为什么 API 与 Worker 必须是两个进程
这是整套架构的分水岭。CPU 推理会占满核心几十秒到几分钟,如果放在 API 进程里,一个转写任务就能把整个 Web 服务卡死。
代价是:API 进程无法直接观测 Worker 的进度。所以"实时进度"这个看似前端的问题,本质上是一个跨进程通信问题——它只能通过 Redis 解决。后面 §5 会看到,这条约束推导出的一连串设计决策,占了这套系统一半的坑。
2.2 状态机与进度分段
PENDING ──▶ PROCESSING ──▶ SUCCESS
                       └──▶ FAILED (+ error_message)
进度条被切成四段,每段含义明确:
| 区间 | 阶段 |
|---|---|
| 0 → 5% | 取任务、置 PROCESSING |
| 5 → 15% | FFmpeg 转码(或复用已有 WAV) |
| 15 → 90% | Whisper 解码(分片模式下按音频绝对时间线性映射) |
| 90 → 100% | 落库分段、终态收尾 |
划分依据只有一个:让用户知道现在卡在哪一类事情上。转码慢是 IO,解码慢是模型,两者对用户的暗示完全不同。
3. 关键实现一:异步转写流水线
3.1 统一音频规整:先消灭格式差异
任意输入先由 FFmpeg 统一转成 WAV 16kHz / 单声道 / PCM S16LE,再喂给模型。这一步看着笨,但它把"格式差异"这个无穷问题压缩成了一个常量——你不用去猜某种容器 + 某种编码在某个版本的解码器里会出什么岔子。
一个容易踩的点:切片时 -ss 必须放在 -i 之后。放在前面按关键帧对齐,全片时间戳会整体偏移;放在后面才是采样级精确。
3.2 WAV 复用的安全条件
已转码的 WAV 可以复用,省一次 FFmpeg。但复用有个前提:开过音频增强的任务不能复用未增强的 WAV。
python
reusable = (
    not task.enhance_audio          # 增强任务必须重新转码
    and os.path.isfile(wav_path)
    and os.path.getsize(wav_path) > 0
)这行代码的价值在于它拦住的是一类静默错误:如果复用错了,任务照样 SUCCESS、进度照样 100%,只是转写质量悄悄变差——这种 bug 靠验收清单是抓不到的,只能靠不变量。
3.3 长音频分片:目标 90s / 上限 120s / 重叠 1.5s
python
step = min(max(TARGET_SEC, 30), MAX_SEC)          # 90s,夹在 [30, 120]
overlap = max(0.0, min(OVERLAP_SEC, 5.0))         # 1.5s

ranges, start = [], 0.0
while start < total - 1.0:
    end = min(start + step, total)
    ranges.append((start, end))
    if end >= total:
        break
    start = max(start + 1.0, end - overlap)       # 保证严格前进,不会死循环
三个数字各有理由:
- 90s 目标 / 120s 上限:单次解码的内存与延迟可控,同时不至于把分片切得太碎导致边界问题变多;
- 1.5s 重叠:跨边界的词至少在一个分片里是完整的;
max(start + 1.0, ...):while循环的安全阀,避免重叠参数配错时步长退化为 0 而死循环。
关键优化:切片在内存里做,不落盘。 WAV 只读一次到 PCM 数组,之后按 [start*16000 : end*16000] 直接切片。老做法是逐片调用 FFmpeg 输出临时文件、再解码、再删除——一圈下来纯属浪费,还多了临时文件清理的责任。
3.4 分片重叠去重
重叠带来重复。去重不能只看时间(那会把"跨边界的后半句"一起裁掉),要文字与词级时间同时确认:完全落在已覆盖区间内的段直接丢弃;跨边界的段保留但把起点夹到游标之后(它仍带着前一片没覆盖到的内容);文字冲突则保留并标记为"待核对",而不是悄悄只裁时间。
3.5 进度映射:一个害死过人的"分母陷阱"
这是本系统最典型的一个 bug,值得单独讲。
progress_callback(processed_seconds, total_seconds) 里的 total_seconds,是传给 Whisper 的那个文件的时长——分片模式下就是分片自己(90s)。如果拿它当分母:
python
# ❌ 错误:分母是分片时长
frac = processed / total_seconds
第 1 个分片很快跑到 100%,映射到 90%;从第 2 个分片开始,min(chunk_offset + processed, ...) 被夹到分片时长,frac 恒为 1.0 → 进度在整个转写过程中再也不会更新一次。
正确写法必须显式把整段时长传进来:
python
absolute = min(chunk_offset + float(processed_seconds), total)   # total = 整段时长
frac = min(max(absolute / total, 0.0), 1.0)
mapped = 15 + int(frac * 75)                                     # 15 -> 90
# 节流不能吃掉区间上限:90 这个"毕业值"必须永远放行
if mapped >= 90 or mapped - state["value"] >= 3:
    state["value"] = mapped
_update_task_progress(session, task_id, progress=mapped)第二个陷阱在同两行里:if mapped - state["value"] >= 3 的节流会把最后一步(88/89 → 90)挡掉,因为差值只有 1~2。区间上限必须无条件放行,否则界面永远停在 90% 不动。
症状识别:任务在第一个分片内冲到约 90%,之后一动不动,但日志显示解码仍在继续。
3.6 幂等:投递可以重复,执行必须安全
Celery 配了 acks_late,崩溃/重启后未确认的消息会被重新投回队列;而 API 侧还有一套"启动恢复未完成任务"的逻辑。两者叠加的后果是同一个任务被投递 N 次(实测一次事故累积 5 份副本,全部指向同一 task_id)。后果比"浪费 CPU"严重得多:重复副本一旦失败,会把前一次的成功结果覆盖成 FAILED。
两道守卫:
python
# 守卫 1:投递前先看 broker 里是否还有该任务的消息
is_pending = is_task_message_pending(task_id)   # 查 celery 列表 + unacked 哈希

# 守卫 2:worker 入口检查终态
if task.status in (SUCCESS, FAILED):
return # 重复投递,直接退出还有一个坑:PROCESSING → PENDING 的复位只能作用于"确实要重派的"任务。把正在运行的任务复位成 PENDING,会让它的状态与进度长期错乱——因为运行中的写入只更新 progress,不会把 status 改回 PROCESSING。
3.7 可取消
CPU 任务必须能取消,否则用户点错一次就得等十几分钟。取消检查被埋在两个粒度上:ASR 解码的每个分段之间、embedding 的每一批之间,且加了 2 秒节流(避免每次分段都查一次库)。
诚实的边界:单次模型调用是不可中断的。分片粒度决定了取消的响应时间上界。
4. 关键实现二:实时进度推送(SSE)
4.1 为什么是 SSE 而不是 WebSocket
| 维度 | SSE | WebSocket |
|---|---|---|
| 数据方向 | 单向(服务端→客户端),正好匹配进度推送 | 双向,能力过剩 |
| 协议 | 纯 HTTP,代理/网关零改造 | 需要 Upgrade 握手,中间件容易拦 |
| 实现成本 | 一个 StreamingResponse |
独立协议栈 + 心跳 + 状态管理 |
| 断线恢复 | 浏览器原生有重连语义 | 全自己写 |
进度推送是单向、低频、可丢弃的:丢一帧进度不影响正确性,下一帧会覆盖。SSE 是这类场景的最优解。
但 SSE 有三个必须自己填的坑,每个都踩过。
4.2 Pub/Sub 没有重放:必须"先订阅、后读快照"
Redis Pub/Sub 是 fire-and-forget,离线期间的消息不存在。所以订阅顺序是硬要求:
1. SUBSCRIBE 该任务的进度频道    ← 必须先做
2. 从 MySQL 读当前行,作为 snapshot 首帧发出
3. 转发后续 publish 的消息,直到终态顺序反过来的话,订阅建立前发生的进度更新会永久丢失,客户端于是能看到一个"跳变"甚至卡住不动。
这引出第二条铁律:MySQL 永远是唯一事实源,Redis 只是镜像。Redis 挂了,转写必须照常跑完,只让进度降级——推送是 fire-and-forget,所有 Redis 异常都被吞掉并只记一条 debug 日志。
python
def _publish_progress(task_id: int) -> None:
    """读回刚刚提交的行再发布 —— 保证订阅者收到的值与库里完全一致。"""
    try:
        with SyncSessionFactory() as read_session:        # 一次性 session
            row = read_session.execute(select(...).where(...)).first()
        if row is None:
            return
        publish_task_progress(task_id, {...})
    except Exception as exc:
        logger.debug("progress publish skipped: %s", exc)  # 绝不冒泡
注意那个 read_session:不要在 commit() 之后复用同一个 session 做只读查询。SQLAlchemy 的 autobegin 会立刻开一个新事务,而它要等下一次 commit() 才结束。实测出现过 350+ 秒的 idle in transaction,持有 REPEATABLE READ 快照、阻碍 undo purge(History list length 只增不减)。只读读回一律用一次性 session。
4.3 心跳必须是"具名数据帧",不能是注释帧
SSE 规范里,以 : 开头的是注释帧。它有个致命特性:浏览器的 EventSource 解析器会完整丢弃注释行。
于是出现了一个极隐蔽的场景——没有 FIN 的连接中断(笔记本休眠、Wi-Fi 切换、NAT 表项老化):
| 用注释帧做心跳 | 用具名数据帧做心跳 | |
|---|---|---|
| 中间设备 | 保持连接不老化 | 保持连接 |
浏览器 onerror |
不触发 | 不触发 |
| 前端能否感知 | 完全不能 | 能(收到 ping 事件即可计时) |
| 结果 | 界面无限冻结,重连永不启动 | 静默看门狗判死 → 走重连阶梯 |
所以心跳改成:
python
def _sse(event: str, data: dict) -> str:
    return f"event: {event}\ndata: {json.dumps(data, ensure_ascii=False)}\n\n"

# 空闲超过 HEARTBEAT_SECONDS 就发一帧具名事件
yield _sse("ping", {"ts": int(time.time())})
event: ping 是具名事件,不会触发 onmessage(只触发 addEventListener('ping')),因此与 snapshot / progress / done 三个业务事件互不干扰。这是个很干净的技巧:用同一条流既保活又给客户端一个可观测的活性信号。
心跳周期取 20 秒:必须 ≤ 30s(见过的最短中间代理 idle timeout),又要远小于各跳的超时。
4.4 每一个 Redis await 都必须有界
一条无界(或半开)的连接会挂住整个生成器——心跳停发、连接被中间设备掐断,而服务端毫不知情。所以:
python
try:
    message = await asyncio.wait_for(
        pubsub.get_message(ignore_subscribe_messages=True, timeout=1.0),  # 内层:1s 空闲是正常的
        timeout=2.0,                                                      # 外层:真卡住的判据
    )
except asyncio.TimeoutError:
    # 真卡住 → 关掉 pubsub,转流内 DB 轮询
...两层的语义必须分清:内层返回 None 是"频道空闲没消息"(完全正常);外层 wait_for 超时才是"Redis 真的挂了"。混在一起会导致空闲频道被误判为故障,或者真故障时静默停住。
顺带一提:异步 Redis 客户端也必须配 socket_connect_timeout / socket_timeout / health_check_interval——最初只有同步客户端配了,异步的裸奔,这就是上面那个坑的源头。
同时提供三层降级链:
Redis Pub/Sub 推送
  └─ 失败 → 同一流内每秒轮询 MySQL
       └─ 失败 → 前端降级到 HTTP 轮询接口
生成器里还有连接寿命上限(约 1 小时,略小于任务执行上限)。到期正常收尾关闭,让客户端重连——重连后首帧 snapshot 会把状态补齐,所以断连零损失。这比留一条孤儿订阅好得多,尤其是经历了静默代理掉线之后。
4.5 终态必须主动结束响应
如果任务已经结束但连接还开着,EventSource 会对已完成的任务无限重连。所以:
python
if initial["status"] in TERMINAL_STATUSES:
    yield _sse("done", initial)
    return                                          # 连接进来时就已经完成

while True:
    ...
    if payload.get("status") in TERMINAL_STATUSES:
        yield _sse("done", payload)
        break                                       # 运行中到达终态
4.6 前端:自己接管重连
浏览器的原生重连用不了:间隔由服务端 retry: 决定,是个恒定值,做不出降频,也无法计数/封顶。所以直接把原生实例关掉,自己写重连循环:
ts
const SSE_RECONNECT_DELAYS = [1000, 2000, 4000, 8000, 15000, 30000]  // 6 档降频
const SSE_JITTER = 0.2                    // ±20% 抖动,避免大量客户端齐步重试
const SSE_HEALTHY_MS = 30000              // 连接存活超过此值才重置重试预算
const SSE_SILENCE_TIMEOUT = HEARTBEAT * 3 * 1000   // 静默看门狗:60s
const SSE_REPROBE_MS = 60000              // 降级到轮询后,每分钟探一次 SSE
四个关键决策:
(1)onerror 必须按 readyState 分支
CONNECTING(0)= 可恢复(网络抖动、代理掐链、寿命到期正常收尾)→ 重连;CLOSED(2)= 致命(HTTP 非 200、Content-Type 不对,如 404/401/5xx)→ 浏览器不会重连,直接降级轮询,别白等 6 次退避。
(2)必须在 onerror 里同步销毁原生实例
ts
source.onerror = () => {
  source.onerror = null
  source.close()      // 否则浏览器会在 retry: 毫秒后自行重连 → 双连接、双计数
  scheduleReconnect()
}
(3)健康判定必须同时要求"活够久"和"收到过帧"
这是最容易写错的一处。只用"连通时长"判定时,"服务端接受连接但永不发帧"的连接会被 60s 静默看门狗判死后重连,而新连接存活又已过 30s → 重试计数被无限重置 → 永远停在第 1 档,永远降级不到轮询。所以:
ts
const healthy = (Date.now() - openedAt) > SSE_HEALTHY_MS && lastFrameAt > 0lastFrameAt > 0 表示"至少收到过一帧"(心跳也算)。沉默的连接不算健康。
(4)重连成功即用 snapshot 覆盖本地状态。Pub/Sub 无重放,断线窗口内的进度只能靠服务端首帧补回,前端无需再补一次 HTTP 请求。
另外,document.hidden 时不判死——后台标签页本就不该重连。
4.7 事故:uvicorn 的优雅关闭被一条 SSE 流永久挂住
这是本系统最"反直觉"的一次事故,值得完整记录。
现象(五个特征同时出现):
- 端口仍在 LISTENING,TCP 能握手;
- 任何请求(包括文档页)都无响应;
- 应用日志彻底静默;
netstat里服务端口的 ESTABLISHED 只增不减;- 进程 CPU 空转。
极容易被误判成"后端挂了"或"服务慢了",实际机制是:
- uvicorn 的
timeout_graceful_shutdown默认值是None,即无限等待; - 一条 SSE 流就是一条永不完成的 in-flight 请求;
- 生成器只监听
request.is_disconnected(),而 uvicorn 在"响应已开始"时shutdown()会直接 return →is_disconnected()永远为False; - 于是关闭流程永久停住 → 只能用强杀重启。
修法:三处启动命令统一加上:
uvicorn ... --timeout-graceful-shutdown 5取 5 秒的理由是收益/代价比:SSE 客户端有重连阶梯、重连后首帧补齐状态,优雅等待毫无收益;而 5s 短于容器默认的 10s stop_grace_period,容器不会走到被 SIGKILL。
附带一条:超时取消会在日志留下 Application shutdown failed + CancelledError——这是预期内的,进程正常退出,不要去"修"它。
4.8 端点自身的三个硬约束
(1)SSE 端点绝不能注入常规的 DB 依赖。长连接会把连接池占满(池子只有 10 条)。必须在生成器内部用短生命周期 session,用完即还。
(2)鉴权要在流建立之前完成。这样未登录请求得到的是干净的 401,而不是一个 200 状态码然后流里发个错误帧——后者会让前端拿到一个"成功建立但内容诡异"的连接。
(3)一条容易被忽略的牵连:EventSource 没有设置请求头的 API(只能改 withCredentials),播放器用的原生 <audio> 元素同样不能自定义请求头。这意味着会话凭证不能放在 Authorization 头里,必须是浏览器自动携带的那种;否则音频播放与进度流这两块核心功能会双双 401,而"接口用 curl 测着都正常"——因为漏掉的恰是浏览器里那两个发不出头的消费者。另外,快照必须按调用方的归属范围过滤,否则进度流本身会变成一个"探测别人任务状态"的旁路。
5. 关键实现三:转写精度
CPU-only 的现实决定了:提升精度的杠杆是上下文与词表,不是更大的模型。实测把 small 换成 large-v3,一首歌的 9 处同音错误只改对 2 处,却新造了一处幻觉,而耗时翻了好几倍。下面四件事零额外算力,优先级全部高于换模型。
5.1 VAD 会"饿死"音乐类音频,必须留自适应回退
vad_filter=True 用的是为语音训练的 Silero VAD。它在一首 272.4 秒的歌里只判出 3.1 秒语音(1.1%)→ 送进模型只剩 3 秒 → 只转出 9 个字。
症状特征:任务 SUCCESS、进度 100%,但结果只有几个字符,时间轴大片空白。极易被误判成"模型不行"。
回退判据用一个很省的办法——faster-whisper 自己已经算好了 info.duration_after_vad,不需要额外跑一遍 VAD:
python
def _vad_starved(info, segments) -> bool:
    total = float(getattr(info, "duration", 0.0) or 0.0)
    after_vad = getattr(info, "duration_after_vad", None)
    if after_vad is None or total <= 0:
        return False
    keep_ratio = float(after_vad) / total
    # 恰好为 0 时故意不回退:没有语音可捞,关掉 VAD 只会让模型对纯音乐"编造文本"
    if keep_ratio <= 0 or keep_ratio >= 0.15:
        return False
    chars = sum(len(seg["text"]) for seg in segments)
    return (chars / total) < 0.5     # 字/秒
三个设计决策:
- 必须两个条件同时成立(保留比例 < 0.15 且 字符密度 < 0.5 字/秒)。只看比例会误伤"1 小时会议、大量静音"(比例低但文本很多);只看字符数会误伤"短音频本来就没几句话"。
- 比例恰好为 0 时不回退。没有语音可捞,关掉 VAD 重跑只会让模型对纯音乐/噪声编造文本,比返回空更糟。
- 不要图省事去调低 VAD 阈值(比如 0.25)。那是全局放宽,会给已经调好的会议场景引入更多噪声与幻觉。
回退那一遍还必须丢掉 initial_prompt 和 hotwords,并关闭前文续接——原因见下一条。
5.2 initial_prompt 会"泄漏"进结果
对 Whisper 来说,initial_prompt 是已经说过的前文,模型会顺着它继续解码。当先验与音频不匹配时(把"这是一段包含多人对话的会议录音"注入一首流行歌),模型宁可续写 prompt 也不听音频——实测输出里逐字出现了 prompt 自身的短语,还伴随"身后的你身后的你…"这种重复循环,置信度只有 0.19。
三条规则:
- 回退分支(
vad_filter=False那一遍)必须去掉 prompt——VAD 已经判定"这不是语音",语音类先验同样失效; - 文件名里的机器 ID 不要进 prompt。手机/即时通讯工具导出的录音名往往是一串随机标识(长度 8 以上、数字占比偏高),它会被当成主题词注入并泄漏到转写结果里——实测在歌词输出中直接出现过文件名片段。用一条启发式规则过滤,同时保留正常短词:
python
def _looks_like_machine_id(token: str) -> bool:
    """长且数字占比高的 token 是标识符,不是主题词。"""
    if len(token) < 8:
        return False
return sum(ch.isdigit() for ch in token) / len(token) >= 1 / 3RTX4090、GPT4All 这类短名在长度门槛之下,不受影响。
- 拿不准就先不注入。"没有 prompt 的干净结果"永远优于"带着错误先验的结果"。
5.3 用 tokenizer 真实预算管 prompt
Whisper 会按 约 224 token 截断 initial_prompt。如果按字符数裁剪,很可能术语还没进去就被截掉了。所以改成用模型自己的 tokenizer 真实计数,总预算 200 token,优先级顺序为:近期上下文 > 术语/hotwords > 主题词。
python
budget = min(max(0, PROMPT_TOKEN_BUDGET), model.max_length // 2 - 1)

def encode(text):  return model.hf_tokenizer.encode(text).ids
def trim(text, allowance, tail=False):
    ids = encode(text)
    if len(ids) <= allowance: return text
    return model.hf_tokenizer.decode(ids[-allowance:] if tail and allowance else ids[:allowance])

# 最后必须校验"拼接后的整体",而不是分别校验各分量
while prompt and len(encode((hotwords + ' ' + prompt).strip())) > budget:
    prompt = trim(prompt, len(encode(prompt)) - 1, tail=True)
最后那个 while 循环很重要:分别预算的几段拼起来会超标,必须对拼接结果做二次收敛。
5.4 跨分片上下文续接
Whisper 内部只有约 30 秒窗口,而分片是 90 秒。每个分片独立解码 ⇒ 分片边界处"上文"归零 ⇒ 同一术语被反复猜成同音词("Issue → ISO"、"Commit → Commute")。
修法很直接:把上一分片的文本尾部(180 字符,只保留最近一片,累积会撑爆预算)作为下一片的 initial_prompt 续接段:
python
prev_tail = ""
for idx, (chunk_start, chunk_end) in enumerate(ranges):
    chunk_segments = transcribe(..., prev_text=prev_tail if (chunked and idx > 0) else None)
    if chunked:
        prev_tail = " ".join(seg["text"] for seg in chunk_segments).strip()
配合 condition_on_previous_text=True(负责片内分段之间的上下文),两者才能覆盖"片内"与"跨片"两级上下文。
副作用要管:condition_on_previous_text=True 在长音频上偶发重复/循环,靠温度回退 + compression_ratio_threshold + log_prob_threshold 兜住;而 VAD 回退那一遍必须把它关回 False——非语音没有"上文"可续,续写只会循环。
5.5 局部二次解码:只重解"值得重解"的地方
整段重跑太贵。所以只挑低置信的局部区域重解:
python
ASR_RERUN_MAX_REGIONS = 2          # 每分片最多 2 处
ASR_RERUN_MAX_AUDIO_RATIO = 0.2    # 额外音频不超过该分片时长的 20%
WHISPER_LOW_CONF_RERUN_BEAM_SIZE = 10
WHISPER_LOW_CONF_RERUN_MAX_AVG_LOGPROB = -1.0候选是否采纳,用解码分数、重复度、非语音占比、字数变化四者综合判定;未改善就保留第一遍:
python
if (candidate
        and 0.6 * old_chars <= new_chars <= 1.5 * max(1, old_chars)     # 字数没暴走
        and _candidate_score(candidate) > _candidate_score(originals) + 0.05):
    segments = merge(segments, originals, candidate)
字数区间那道门是防幻觉的关键——二次解码在低置信区域很容易"编得更长",只靠分数会被骗过。
5.6 三档质量档位
把精度/速度的权衡交给用户,但给出有意义的默认值:
| 档位 | beam | 词级时间戳 | 局部重试 |
|---|---|---|---|
| 快速 | 2 | 仅开说话人分离时 | 关闭 |
| 均衡(默认) | 5 | 开启 | 有预算上限 |
| 精细 | 8 | 开启 | 有预算上限 |
为什么默认是均衡而不是快速:快速档的准确性尚未经过人工参考稿评估,而它省下的时间远小于"结果需要重跑"的代价。
5.7 缓存键必须"精确到请求"
缓存是纯计算加速,MySQL 里的发布结果仍是页面与导出的唯一事实来源。键里包含:音频内容哈希、模型权重文件指纹(大小 + 修改时间)、faster-whisper 版本、prompt/hotwords、语言、档位、全部解码参数、VAD 回退阈值、重试参数。
两条容易漏的规则:
- 不同请求不能互相替代。少一个参数就可能让"改了词表的请求"命中"老词表的结果";
- 命中返回深拷贝,且分片的时间偏移必须在写入缓存前处理干净,否则偏移会污染缓存。
6. 关键实现四:说话人分离
6.1 它是独立阶段,不是 ASR 的一部分
分离必须独立于 ASR,理由有三个:
- ASR 调优(prompt、VAD、重试)已经踩坑修好,换全家桶方案会把这些全丢掉;
- CPU 上分离很慢,必须做成任务级开关、默认关;
- 分离失败绝不能影响文本——文字是主交付物,说话人是增强信息。
所以流程是:ASR 先出文字与词级时间戳 → 分离独立跑 → 按时间把说话人贴回分段。
6.2 引擎选型:为什么不是 pyannote
最直接的原因是令牌:主流方案(pyannote 系列)模型仓库是 gated 的,需要签署许可 + 令牌才能下载,而目标部署网络无法直连上游仓库。没有令牌 ⇒ 不可用。
改用公开仓库、免令牌的 SpeechBrain ECAPA-TDNN 声纹模型(走可用的镜像站下载)。链路全部自建:
16k 单声道 WAV
  └─ 独立 Silero VAD(多尺度窗口)
       └─ 1.5s 短窗 + 3s 上下文融合,步长 1.5s
            └─ 质量筛选(排除静音/削波)→ 可靠窗口作聚类种子
                 └─ ECAPA embedding(分批编码,每批 16 窗)
                      └─ Agglomerative 聚类(cosine / average linkage)
                           └─ 簇原型 + Viterbi 换人惩罚重评分 + 拒判
                                └─ 按段中点贴回 SPEAKER_XX
几个值得说的设计:
- ASR 分段不再决定声纹窗口。早期做法是"复用 Whisper 分段当语音区",但分段边界由文字决定、不等于声学边界。改成独立 VAD 后,声纹窗口的质量稳定得多。
- 至少 1 秒的可靠窗口才有资格当聚类种子;短应答可以归到已有原型,没有种子就保持"未知"。
- 聚类最多抽样 2000 个种子,其余按原型归属——把平方级成本按住。
- 拒判(abstention):相似度不足或与次优候选差距不够时,宁可返回
None。没有把握就不要编。
6.3 人数判定:一个阈值是不够的
最初"几个人"只由一个合并阈值(cosine / average linkage,0.75)决定,只有合并、没有拆分 ⇒ 同性别、音色接近的两个人必然被并成一个。
指纹很好认:某个簇的簇内平均余弦距离明显高于其他簇(实测一支 0.233,另两支 0.14~0.17)且占窗口大头;把它拆开,两半质心距离只有 0.5288 < 0.75。
修法是在聚类后加一道分裂审计,四道门全过才拆:
| 门 | 阈值 | 含义 |
|---|---|---|
| 簇内散度下限 | 0.20 | 只审计"松"的簇,紧的簇免检 |
| 二分处平均链接高度 | 0.55 | 拆的位置必须足够"分得开" |
| 拆后两半内部散度上限 | 0.20 | 两半都得是"紧"的 |
| 两半最小窗口数 | 4 | 两半都要够大(防噪声切分) |
| 封顶 | 8 人 | 保护上限 |
关键:判据和基础聚类用同一把尺子(average + cosine),所以"合并高度 0.55"可以和"合并阈值 0.75"直接对照。
阈值不是拍出来的:把全部 8 份真实声纹缓存(.npz,不需要模型也不需要数据库)离线重跑对照——唯一发生分裂的就是那一条问题录音(2 → 3 人,无标签窗口 2 → 0),而两场 4 人长会议(478s / 704s)一条分裂记录都没产生(被门 ③④ 挡住)。要改判据,就再用这批缓存重跑一遍。
而且:不要为了单个任务去全局调低合并阈值——它同时是所有任务的合并尺度,调低必然过度分裂(同一个人被切成两个)。人数已知且素材敏感时,直接用任务参数强制指定人数,完全绕开这套判据。
6.4 音乐/纯音乐:自动跳过,而不是硬贴标签
同一首 272.4 秒的歌,分离侧的 VAD 只判出 2.304 秒语音(两个窗口),全曲几乎无声纹 → 绝大部分分段拿不到说话人 → 满屏"待确认"。
症状特征:任务 SUCCESS、分离显示"已完成",但列表满屏"待确认"。这不是 bug,是素材类型不对——对歌曲做说话人分离本身没有意义。
修法是让系统自己识别并诚实地跳过:
python
if diar_metrics.get('skipped_reason') == 'insufficient_speech':
    task.diarization_status = 'review'
    task.diarization_error = (
        f"未检测到有效语音(语音占比仅 {audio_coverage * 100:.1f}%,"
        "音频可能为歌曲/纯音乐),已跳过说话人分离;转录文本已保留"
    )
    # 不抛异常、不改写任何 segment.speaker
四条不变量:
-
语音占比不足 = 跳过,不是失败。阈值门同时下在两处:特征提取前(不达标连声纹模型都不加载,省掉最贵的一步)和主入口(这一层是为了让命中旧缓存的"修复前结果"也走跳过路径)。
-
"已完成"要有门槛。原来
done if speaker_count门槛过低——仅凭一个窗口聚出 1 人就报"已完成",与满屏"待确认"自相矛盾。现在必须语音占比达标且 turns 非空。 -
两个覆盖率口径并存,各有各的语义:
coverage分母是语音秒数,含义是"进入声纹的语音里被拒判的比例"——这个语义没错,不要改;audio_coverage分母是音频总时长,才是"全片覆盖率"。
这个区分是被一次误导救回来的:界面曾显示"自动声纹拒判 41.0%",而真实情况是全曲 99.2% 从未进入分离流程。分母选错,指标就会撒一个比"没数据"更危险的谎。
-
两种"待确认"不能合并。原来的"待确认"标记有两个来源:说话人归属待确认、以及分片边界的文字冲突。后者会让没开分离的任务也冒出说话人"待确认"。修法是给边界冲突的 span 打上
review_kind='boundary',后端只认非 boundary 的标记,前端显示为"待核对"并使用独立文案。别把这两处再合并回一个标记。
6.5 歌曲场景还暴露了置信度的局限
歌词逐句核对出 9 处同音错误,而置信度全部在 0.70~0.82,高于 0.6 的告警阈值 → "待校对"队列是 0。再次印证 §5 的结论:置信度是解码质量的度量,不等于语义正确率;对音乐类素材,avg_logprob 基本失去参考价值。
6.6 展示层与数据层的分界:改名不等于改标签
用户想把"说话人 1"改成"张三"。一个看起来很自然的做法是直接改写 segment.speaker。这是错的,而且不可回退。
因为 segment.speaker 是稳定机器标签,它同时是:词级 spans 的说话人键、合并/单段修正/待确认队列的判定依据、四种导出格式的取值来源。把它改成真实姓名,会导致段级标签与词级 spans 分裂 → 同一个人出现两个标签 → 合并与队列全乱。
正确做法是任务级映射表:{"SPEAKER_00": "张三"},替换式保存(接口收到的即全量状态),不带某标签或值为空 ⇒ 回落"说话人 N";合并说话人时原标签的姓名顺延到目标标签。数据层一个字节都不改。
6.7 版本化:让"重跑"和"人工修改"共存
分离结果、词级时间轴、派生句段、配置与耗时,整体存成一次 analysis run 的 JSON(不拆成四张关系表),任务上放一个"当前发布版本"指针,完整 run 与指针在同一短事务提交。
由此得到几条保护:
- 页面和四种导出共同读同一个发布版本 → 三者永远一致;
- 失败或回滚不切换指针 → 半成品不会上线;
- 分离异常时文字保留、界面显示失败,未知说话人不伪造编号;
- 人工修正生成新版本并标记
manual;重跑保留人工标签与已合并句段; - 文字被人工改过之后,不再套用旧的词级派生句段(时间对不上了)。
6.8 软删除:宁可留标记,不可删行
分段删除必须是软删除(加一个 deleted 标记位)。原因很硬:词级 spans 以分段序号为键,硬删一行就是不可修复的空洞——只能整场重跑才能补回来。而且误删必须可逆。
避免"改一处漏一处"的关键是排除点只能有一处:
python
def visible_sources(...):
    for segment in segments:
        if getattr(segment, "deleted", False):
            continue        # ← 唯一排除点
yield segment四种导出、详情列表、说话人标签收集全部从这里继承;将来加第五种导出格式也自动正确。绝对不要在每个导出分支各写一次判空。
配套两条:
- 详情响应把已删分段单独放在
deleted_segments,不要塞回主列表加标记——主列表必须一直等价于"用户手里还有什么",否则说话人计数、四个筛选队列、导出都要各自记得判一次。 - 全文只在仍是机器拼接时才重算:
before = join(可见段)→ 翻标记 →after = join(可见段)→if task.text == before: task.text = after。用户手工整理过全文时不许覆盖。
7. 前端:几个"看不出问题但用户会骂"的点
7.1 一屏一个滚动容器,禁止嵌套滚动
布局是固定的:html/body → 布局容器(100vh) → 主区(overflow:hidden) → 页面根(overflow:hidden) → 卡片(overflow:hidden),页面级永不出现滚动条,滚动只发生在内容区。
反面案例很典型:详情页左栏自带 overflow-y:auto,里面包着一个会涨到 30 行的自适应高度文本框。笔记本(约 768px 高)下可用高度只有约 400px,而文本框会长到约 720px → 外层滚动条 + 文本框内部滚动条同时出现(用户报的"2 个滚动条")。
正确姿势:内容区自身是唯一滚动体,内部元素必须"只长不滚";多视图用标签页切换而不是并排分栏;文本框用无上限自适应高度(只给最小行数,不给最大行数)让它长满。
同理,表格页必须给表格像素级高度:默认不滚的表格行数一多会把分页一起挤出容器被 overflow:hidden 裁掉(无滚动条、内容直接消失)。做法是包一层 overflow:hidden 的容器、用 ResizeObserver 量高再传给表格的 max-height。只有表格主体一个滚动条,分页永远可见。
7.2 阅读字号三档:必须走 CSS 变量,且三件事一起缩放
字号档位(小 13 / 中 14 默认 / 大 16)存在本地,是纯前端阅读偏好:不进数据库、不影响导出。
传递只能靠 CSS 变量——因为字号写在子组件的 scoped 样式里,props 够不到,只有 CSS 变量能穿透 scoped。
而且三件事必须一起缩放,只改字号一定翻车:
- 行高(1.6 / 1.7 / 1.8)——不跟,大字会挤成一坨;
- 行首时间列宽(50 / 52 / 58)——栅格列是固定像素不会自己长,13px 等宽时间串在 52px 列里会折行;
- 行内编辑框字号——不同步会出现"16px 的段落点开变成 14px 输入框"的跳变。
反过来,界面那一层不跟字号放大:工具栏、图例、按钮、图标固定 12px。它们是界面,放大只会让界面变笨重。
7.3 后端时间是 naive UTC,前端必须按 UTC 解析
模型用 datetime.utcnow(无时区),序列化出来是 2026-09-14T01:31:08.920(没有 Z)。new Date() 会把它当成本地时间解析 → 界面时间整体差一个时区偏移(本机实测差 8 小时)。
统一走一个 parseServerDate():无时区后缀就补 Z,带 Z / +08:00 的原样通过。组件里不要直接 new Date(...)。
7.4 局域网 http 下没有剪贴板 API
navigator.clipboard 只在安全上下文(https / localhost)可用。这类系统通常部署在内网、以 HTTP 明文访问,所以任何"复制到剪贴板"都必须保留降级分支:
ts
if (navigator.clipboard?.writeText) { await navigator.clipboard.writeText(text) }
else { /* 隐藏 textarea + document.execCommand('copy') */ }
漏了这条,功能在真实部署环境里直接失效——而本地开发(localhost)永远测不出来。
7.5 图标工具条要"安静",但要能被触屏找到
分段行里的动作(回听、校对、改说话人、删除)如果都写成文字,会和正文抢注意力——正文是文字、动作也是文字,两层同质信息互相干扰。
改成:三列网格 时间 | 正文 | 工具条,工具条用 16px 自绘图标,opacity:.5,hover / 聚焦时提到 1。
但必须写 @media (hover: none) { opacity: 1 }——否则触屏设备上这些动作等于被藏起来。用 opacity 而不是 display:none,保留可点击、可聚焦。
还有一条:徽标内联在正文里时必须加 @dblclick.stop。@click.stop 只挡 click,双击照样冒泡到正文行 → 一边弹改名弹窗一边进入文字编辑。
7.6 破坏性操作:二次确认,且焦点不能落在确认键上
两类"删除"代价完全不同,文案必须说实话:
| 操作 | 代价 | 文案 |
|---|---|---|
| 删分段 | 软删除,可恢复 | "内容仍保留在『已删除』队列,可随时恢复" |
| 删任务 | 真删(音频 + 结果),不可恢复 | "永久删除,无法恢复" |
确认框里要回显时间区间 + 段序号 + 文字开头(长文截到 3 行),让人核对"删的正是这一行"。只写一句"确定吗"等于没确认。
最关键的一条:确认框的 autofocus 默认是 true,会把焦点给确认键 → 手还在键盘上时一个回车就删掉了。置为 false 后,焦点陷阱落不到确认键上,回车不会触发确认(真实浏览器实测:弹窗打开瞬间 document.activeElement 是弹窗容器,按 Enter 时弹窗保持打开、数据不变)。取消路径交给 Esc 和"取消"按钮。
另外,弹确认之前要有一个同步闸门(一个布尔 ref):确认框的遮罩要下一个 tick 才渲染,不加闸门时"极快双击"会在遮罩出现前再弹出一个,两个框叠着。
8. 效果数据
8.1 精度/效率优化的实测(CPU int8,small 模型,中文,60 秒真实会议片段)
| 请求 | ASR 耗时 | 端到端 | ASR 缓存 |
|---|---|---|---|
| 均衡档首次 | 17.16s | 19.49s | 未命中 |
| 快速档首次 | 6.86s | 6.86s | 未命中 |
| 均衡档重复 | 0.047s | 0.047s | 命中 |
跨进程冷启动场景:首次联合分析 26.03s;新进程重复请求命中 ASR 与声纹双缓存为 6.17s。
诚实说明:首行包含模型冷加载,后两行模型已驻留,不能把比值直接当成固定加速倍数。基准为服务调用,不含上传、数据库、UI 和 FFmpeg。
8.2 声纹特征复用
一场全长录音首次声纹分析 182.56 秒(360 个窗口);复用同一份声纹特征的两个后续任务分别 2.44s / 2.89s。三者发布的时间轴哈希一致,原始转写全文哈希与备份一致。
只改变人数可以复用声纹特征再聚类;改变 ASR 文字、模型或分段都不会改变声纹特征——这个缓存边界划得清楚,是"改个字不用重跑声纹"的前提。
8.3 端到端
一条联合流程任务在 worker 重载后 SUCCESS,两个缓存均命中,含 FFmpeg 与数据库的总耗时 8.42 秒。四格式导出、发布回滚、同音频不同 ASR 时间轴一致性、文字哈希、重跑后人工修正保留——均已验证。
9. 踩坑速查表
| # | 坑 | 症状 | 根因 / 修法 |
|---|---|---|---|
| 1 | 分片进度分母用错 | 第一个分片内冲到 ~90%,之后不动 | 分母必须是整段时长,不是分片时长 |
| 2 | 进度节流吃掉上限 | 永远停在 90% | 区间上限值必须无条件放行 |
| 3 | 重复投递 | 同一任务被投递 5 次,后一次失败覆盖前一次成功 | 投递前查 broker + worker 入口查终态 |
| 4 | idle in transaction |
进度长时间不变,事务挂 350s+ | commit() 后不要复用同一 session 做只读查询 |
| 5 | SSE 注释帧做心跳 | 界面无限冻结,不触发重连 | 注释帧被浏览器完全丢弃,改具名数据帧 + 静默看门狗 |
| 6 | 异步 Redis 客户端无超时 | 心跳停发、连接被掐 | 每个 await 加 wait_for,客户端配 socket 超时 |
| 7 | 优雅关闭被 SSE 挂死 | 端口在听、任何请求无响应、日志静默、日志 CPU 空转 | --timeout-graceful-shutdown 5(默认是 None = 无限等) |
| 8 | VAD 饿死音乐 | SUCCESS 但只有几个字,大段时间轴空白 | duration_after_vad 双条件回退;别调低全局阈值 |
| 9 | initial_prompt 泄漏 |
输出里出现 prompt 自身短语 + 重复循环 | 回退分支去 prompt;文件名机器 ID 过滤 |
| 10 | 字段名写错 | 置信度恒为 NULL,低置信高亮成死代码 | avg_logprob(中间没有下划线);改 getattr 前先核真实字段 |
| 11 | 语言探测静默失败 | 中文 prompt 与词表从未生效 | detect_language() 不接受路径,必须传解码后的数组 |
| 12 | 只给 ffmpeg 留 stderr 开头 | 报错只有构建 banner,无法诊断 | 留末尾 500 字符 |
| 13 | 一个人数阈值 | 同性别两人必被并成一个 | 合并阈值 + 聚类后分裂审计四道门 |
| 14 | 指标分母错 | 显示"拒判 41%",实际 99.2% 未进入流程 | coverage(分母语音)与 audio_coverage(分母总时长)分开 |
| 15 | 两类"待确认"合并 | 没开分离的任务也冒出说话人待确认 | span 打 review_kind='boundary',前后端都只认非 boundary |
| 16 | 硬删分段 | 词级 spans 出现不可修复的空洞 | 软删除 + 唯一排除点 |
| 17 | naive UTC 前端解析 | 界面时间差 8 小时 | 无时区后缀补 Z 再解析 |
| 18 | 局域网剪贴板 | 功能在真实环境直接失效 | 保留 execCommand('copy') 降级 |
| 19 | 确认框焦点默认在确认键 | 手在键盘上,一个回车就删了 | autofocus: false |
| 20 | 嵌套滚动 | 同一屏两个滚动条 | 一屏一个滚动容器,内部元素"只长不滚" |
10. 边界与后续
诚实地列出当前没做/做不到的:
- 人工 CER / DER 盲测尚未完成。目前的聚类数与标签覆盖率都是算法结果,不等于人工准确率。
- 重叠语音(抢话)没有真正分离。现在的 turns 是"独占"的,不代表恢复了两条人声。
- CPU 首次推理、大录音整段 PCM 内存、进程常驻模型内存都还需要在目标部署机上做压力验收。
- 单次模型调用不可中断,取消的响应时间上界由分片粒度决定。
- 大表加外键/改列类型会触发整表重建并持锁。小表无感,表一大就是停机风险——写迁移前先用
information_schema估体量,并优先"加列 / 加索引"这类 in-place 操作。 - 存储层已抽象出后端接口(预留对象存储),当前只有本地后端。
下一步方向(按性价比排序):
- 先做人工参考稿评测,把 CER/DER 变成可回归的指标,再谈任何阈值调整;
- 补真实重叠语音检测,把"抢话"从"未知区间"里区分出来;
- 在目标部署机做全面压力验收,确定并发与内存上界;
- 再评估 GPU / 更大模型 / 新声纹模型的收益——在 1、2 完成之前,换模型只是把不确定性换个地方。
11. 小结
回头看,这套系统里真正的功夫不在"调通一个语音模型",而在四件事:
- 把进程边界当成一等公民。API 与 Worker 分开的那一刻,"实时进度"就从 UI 问题变成了跨进程通信问题,Pub/Sub 无重放、心跳可观测性、Redis 挂掉不能影响主流程,全都由这条边界推导出来。
- 区分"数据"和"展示"。说话人改名只做展示层映射、软删除只加标记位、阅读字号不进数据库、缓存只加速计算而 MySQL 是唯一事实源——这几条划清楚之后,系统才敢被人改。
- 指标的口径比指标本身重要。进度分母、覆盖率分母、健康判定条件,每一个都是"看起来对但会在极端情况下撒一个比没数据更危险的谎"的地方。
- 精度杠杆在上下文与词表,不在模型大小。分片上下文续接、tokenizer 预算、术语词表、VAD 回退——四个零算力手段,优先级全部高于换模型。